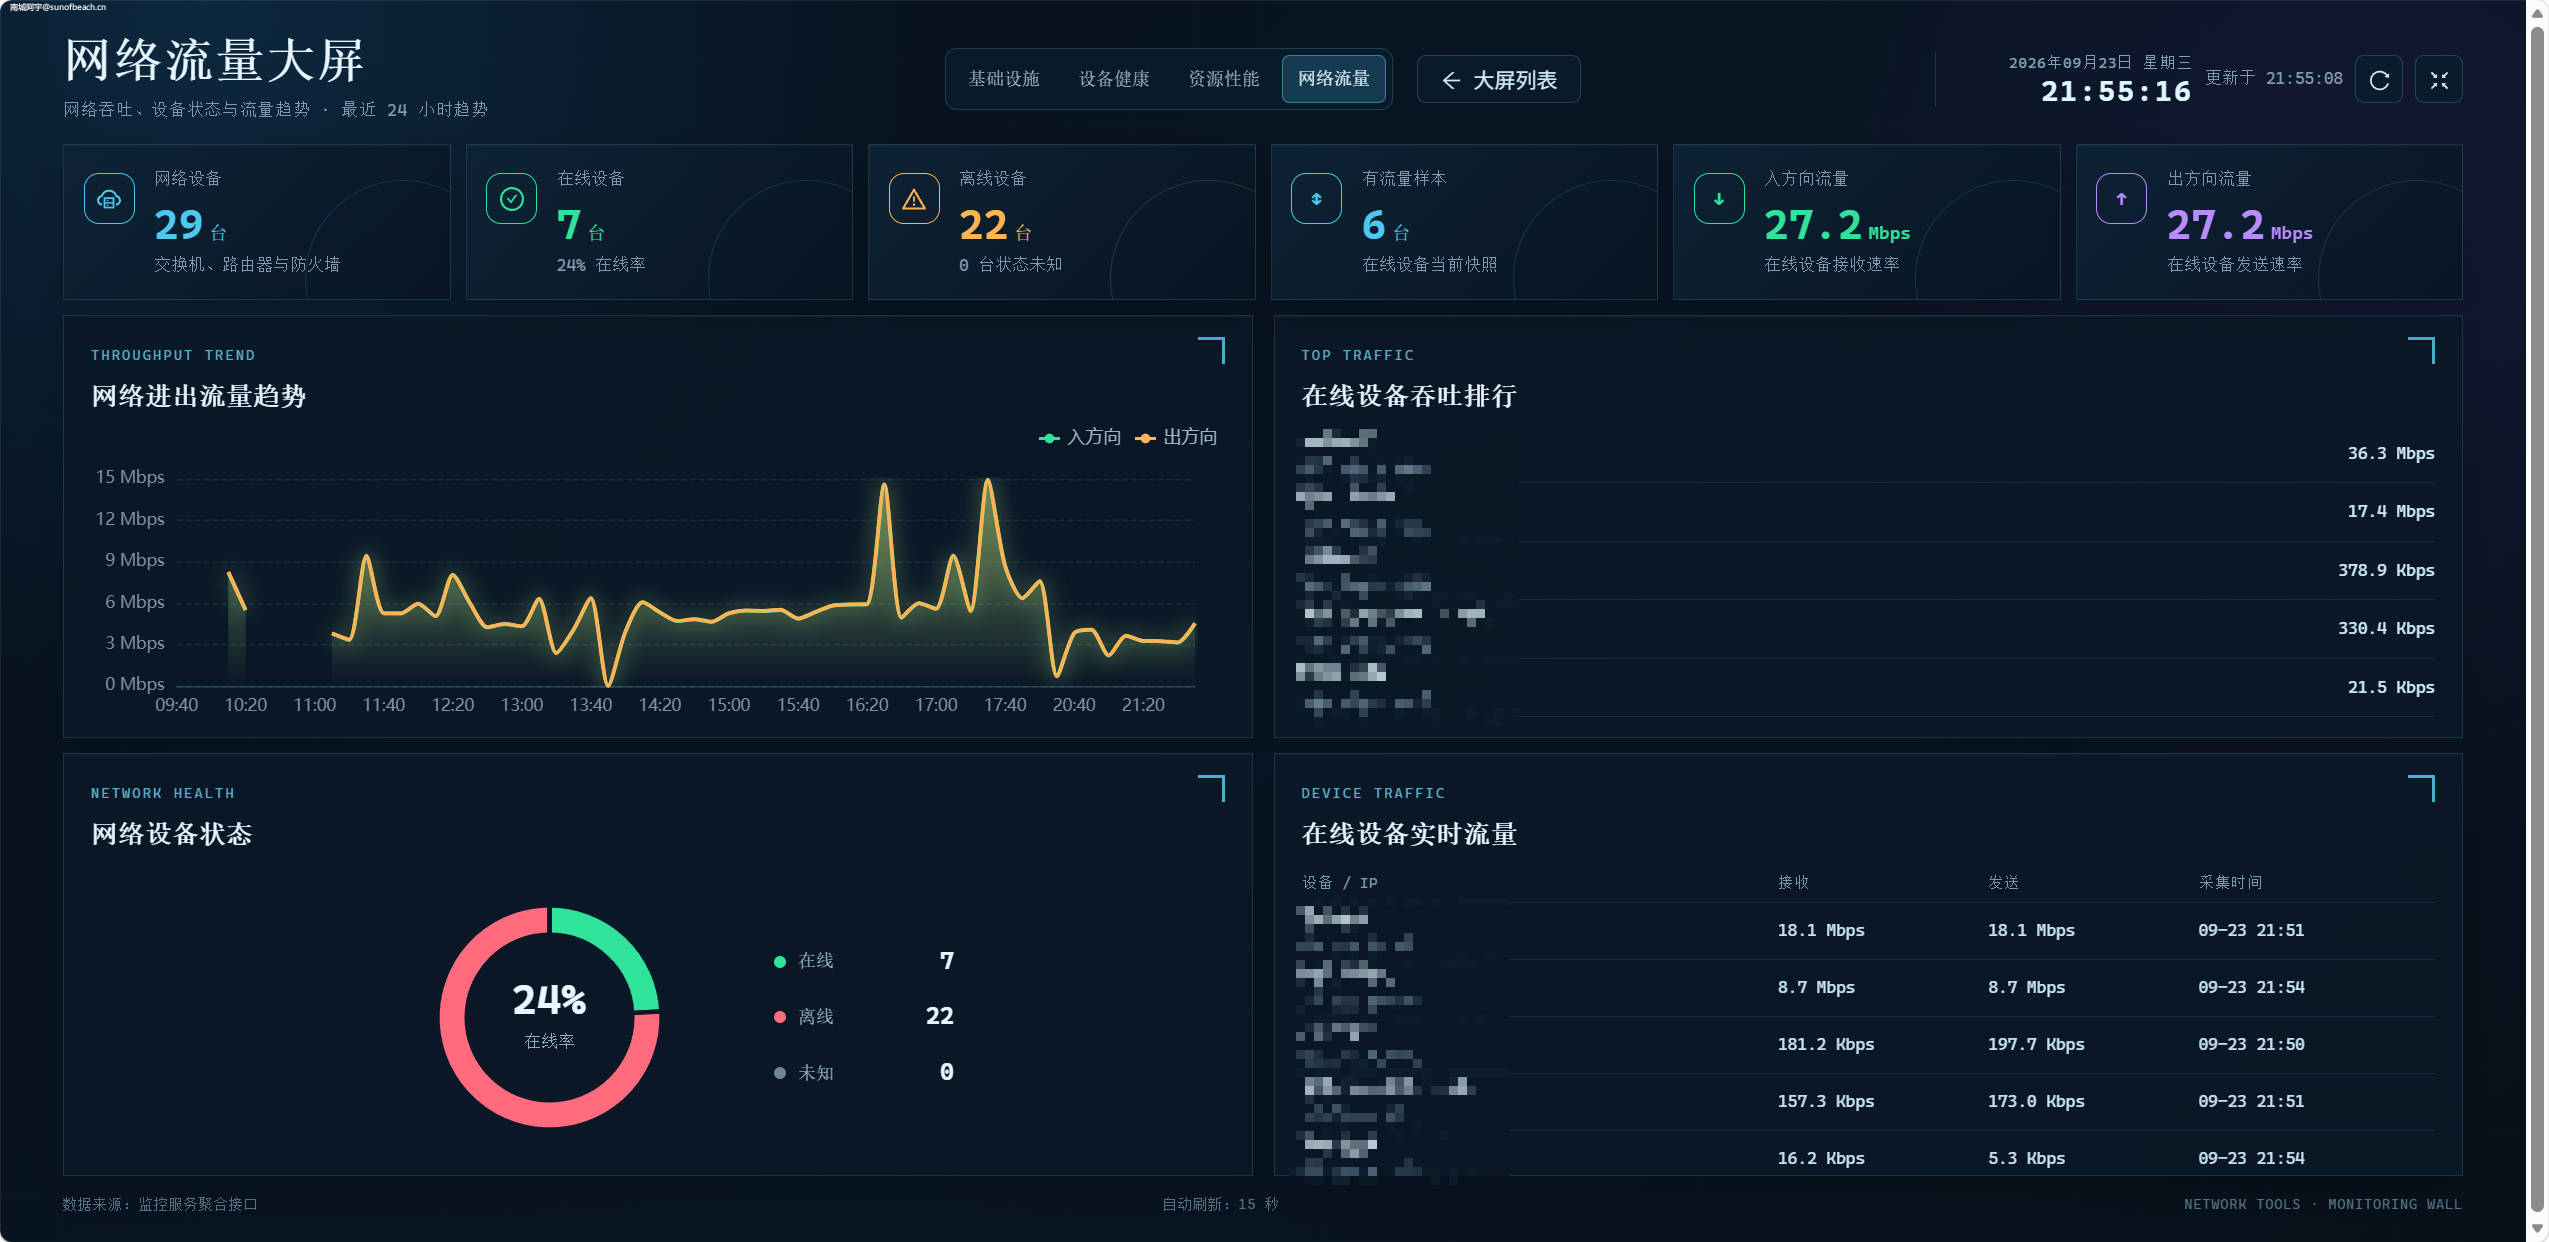
前段时间,在管理服务器上遇到了不少的问题,虽然大多数的问题都是相似的,但是找一堆资料确实头疼,因此整理了一个运维的系统面板。
遇到的痛点
证书过期
有好几次了,都是用户反馈哪个网站登录不上,图片展示不出来等等。经过服务器排查,日志排查,最后才发现证书过期了,这时发现一上午已经过去了。
发现证书过期了吧,又得找是哪个平台下的,平台下的哪个账号,折腾来折腾去,一个小小的可预防的问题,缺影响了线上的用户体验。
结合这个痛点,我将使用的证书统一整理到一个平台,并通过监测证书的有效期、并配置好证书的用途、哪个平台下、平台的哪个账号、设置一个预警期、配置好邮件。
当证书的过期时间到预警期内,我就可以登录平台统一查看相应的信息。
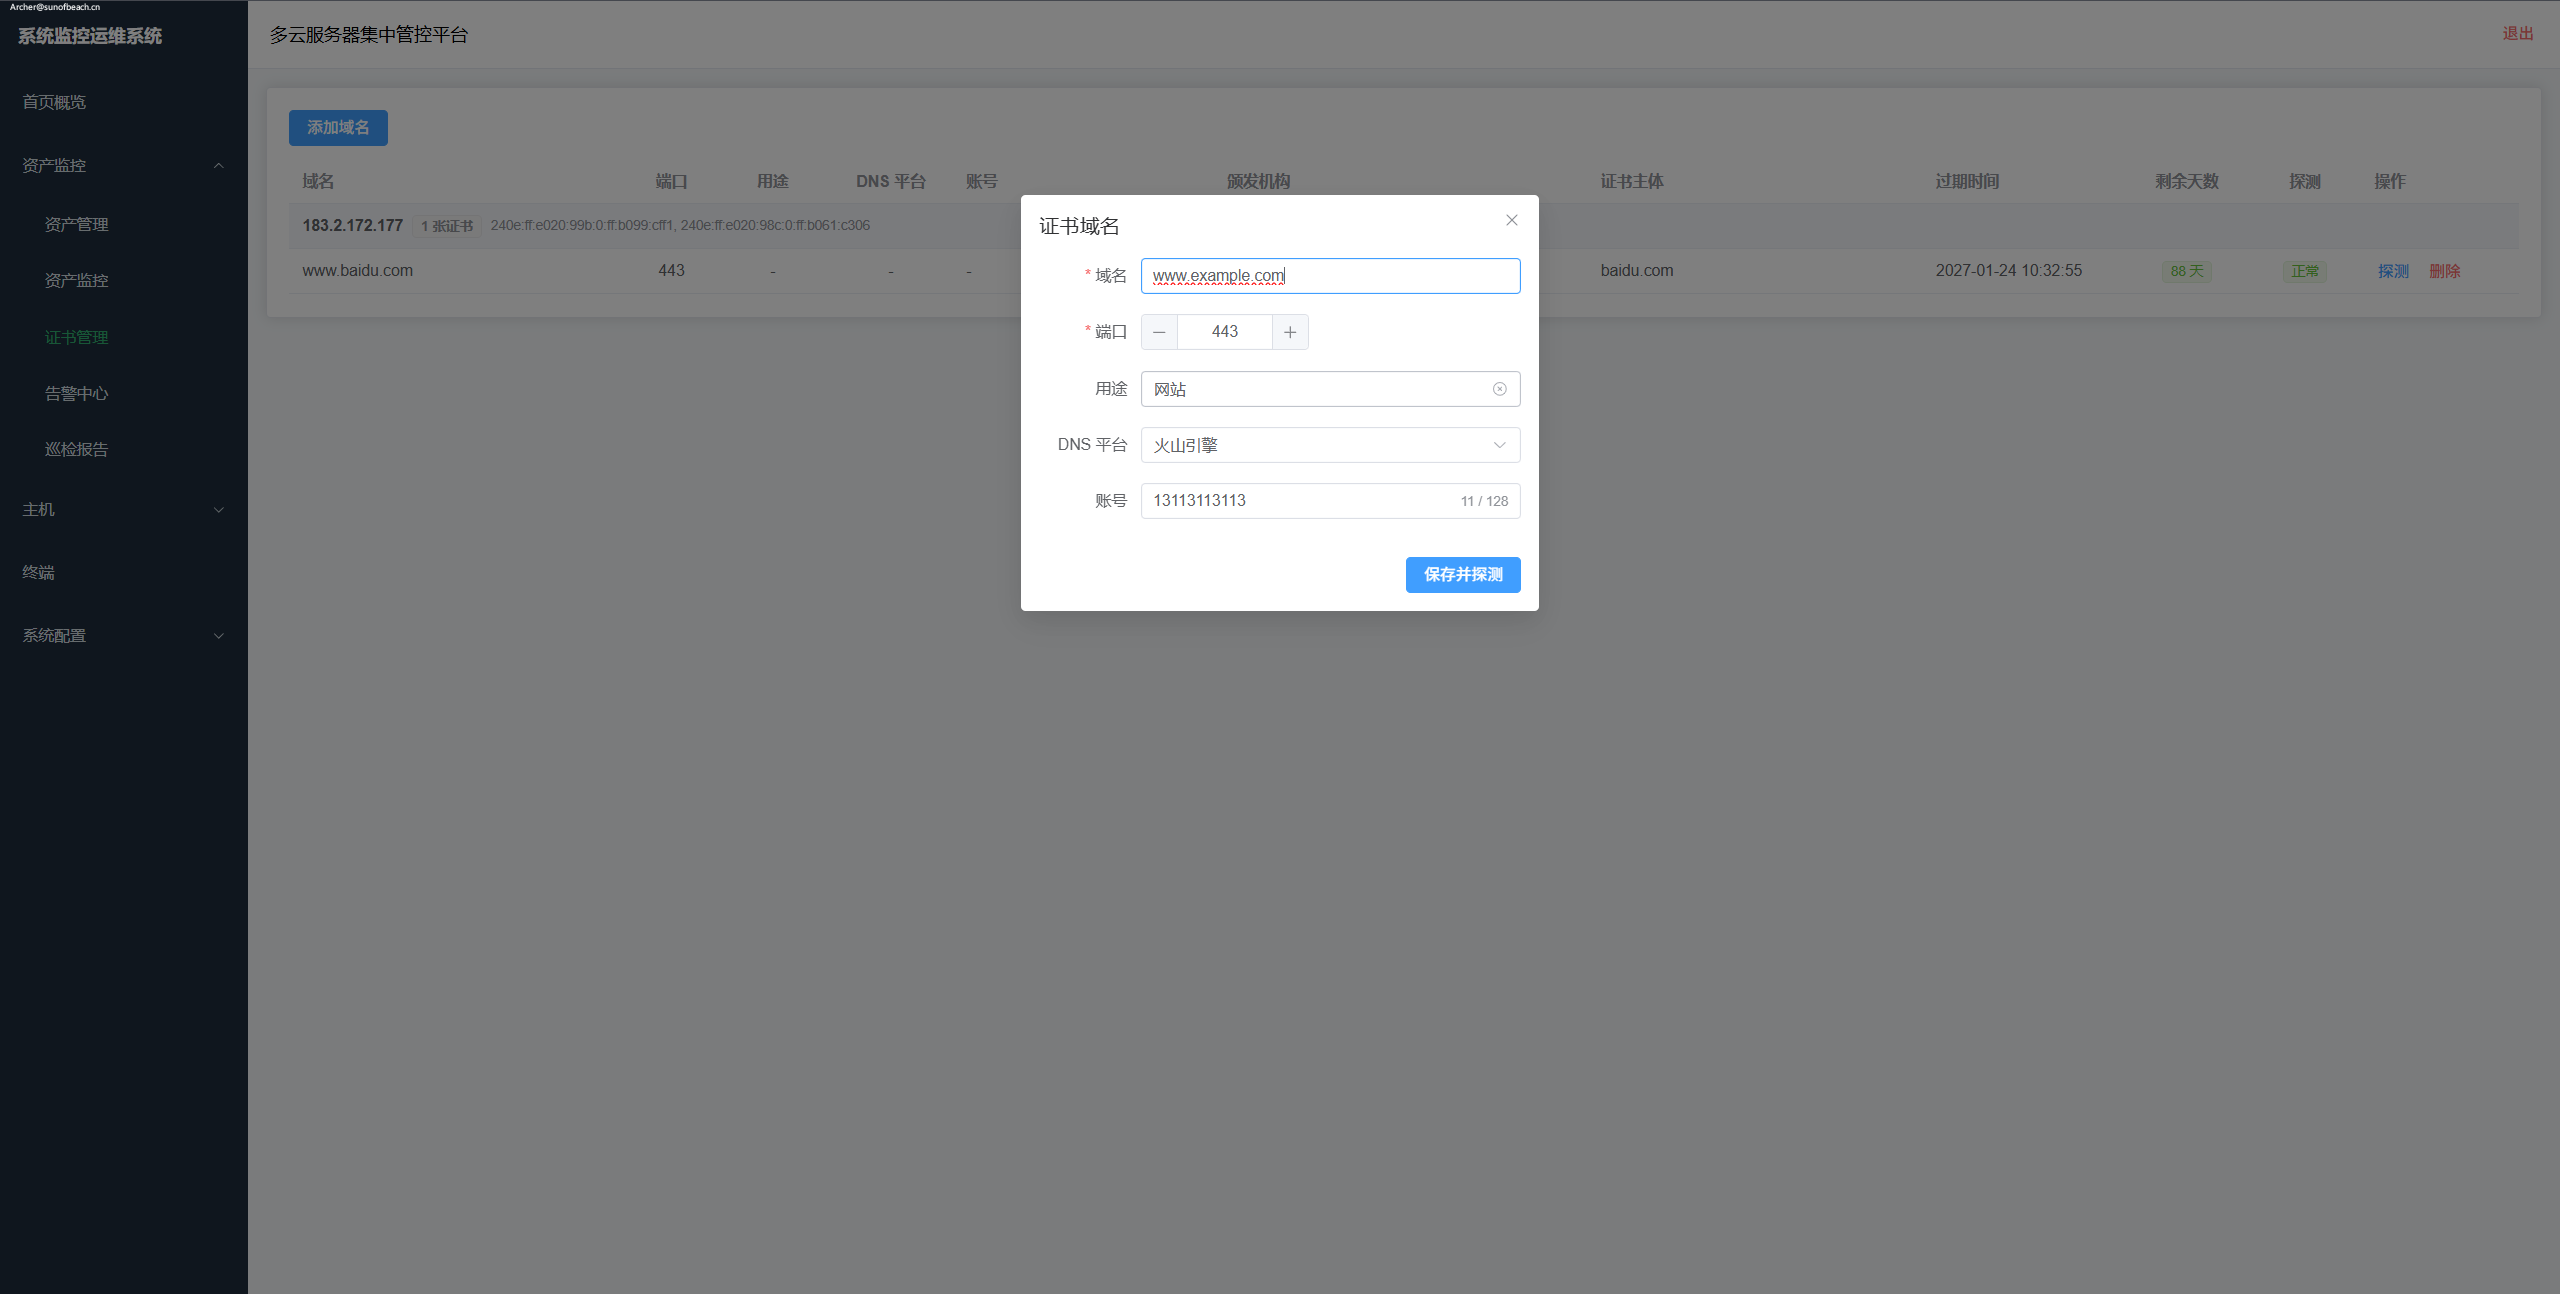
那么我就可以方便的知道哪个平台哪个账号哪台服务器去进行证书的更新。
磁盘满载
也遇到过,因为磁盘满载导致的服务器中redis无法写入的问题。在确定这个无法登录的问题时,我没有第一时间去查看磁盘的问题,而是查了redis的状态、服务的状态等等。后面发现redis是正常的,运行的程序也是正常的。后面查查这查查那才发现磁盘满了。
其实导致磁盘增长的原因并不多,就我目前遇到的而言,要么就是迭代程序时留下的旧的安装包,比如docker的镜像;要么就是一些比较大的系统日志;还有就是docker容器中保存在服务器中的文件;
结合上述的内容,我认为磁盘空间也是需要进行监测的。
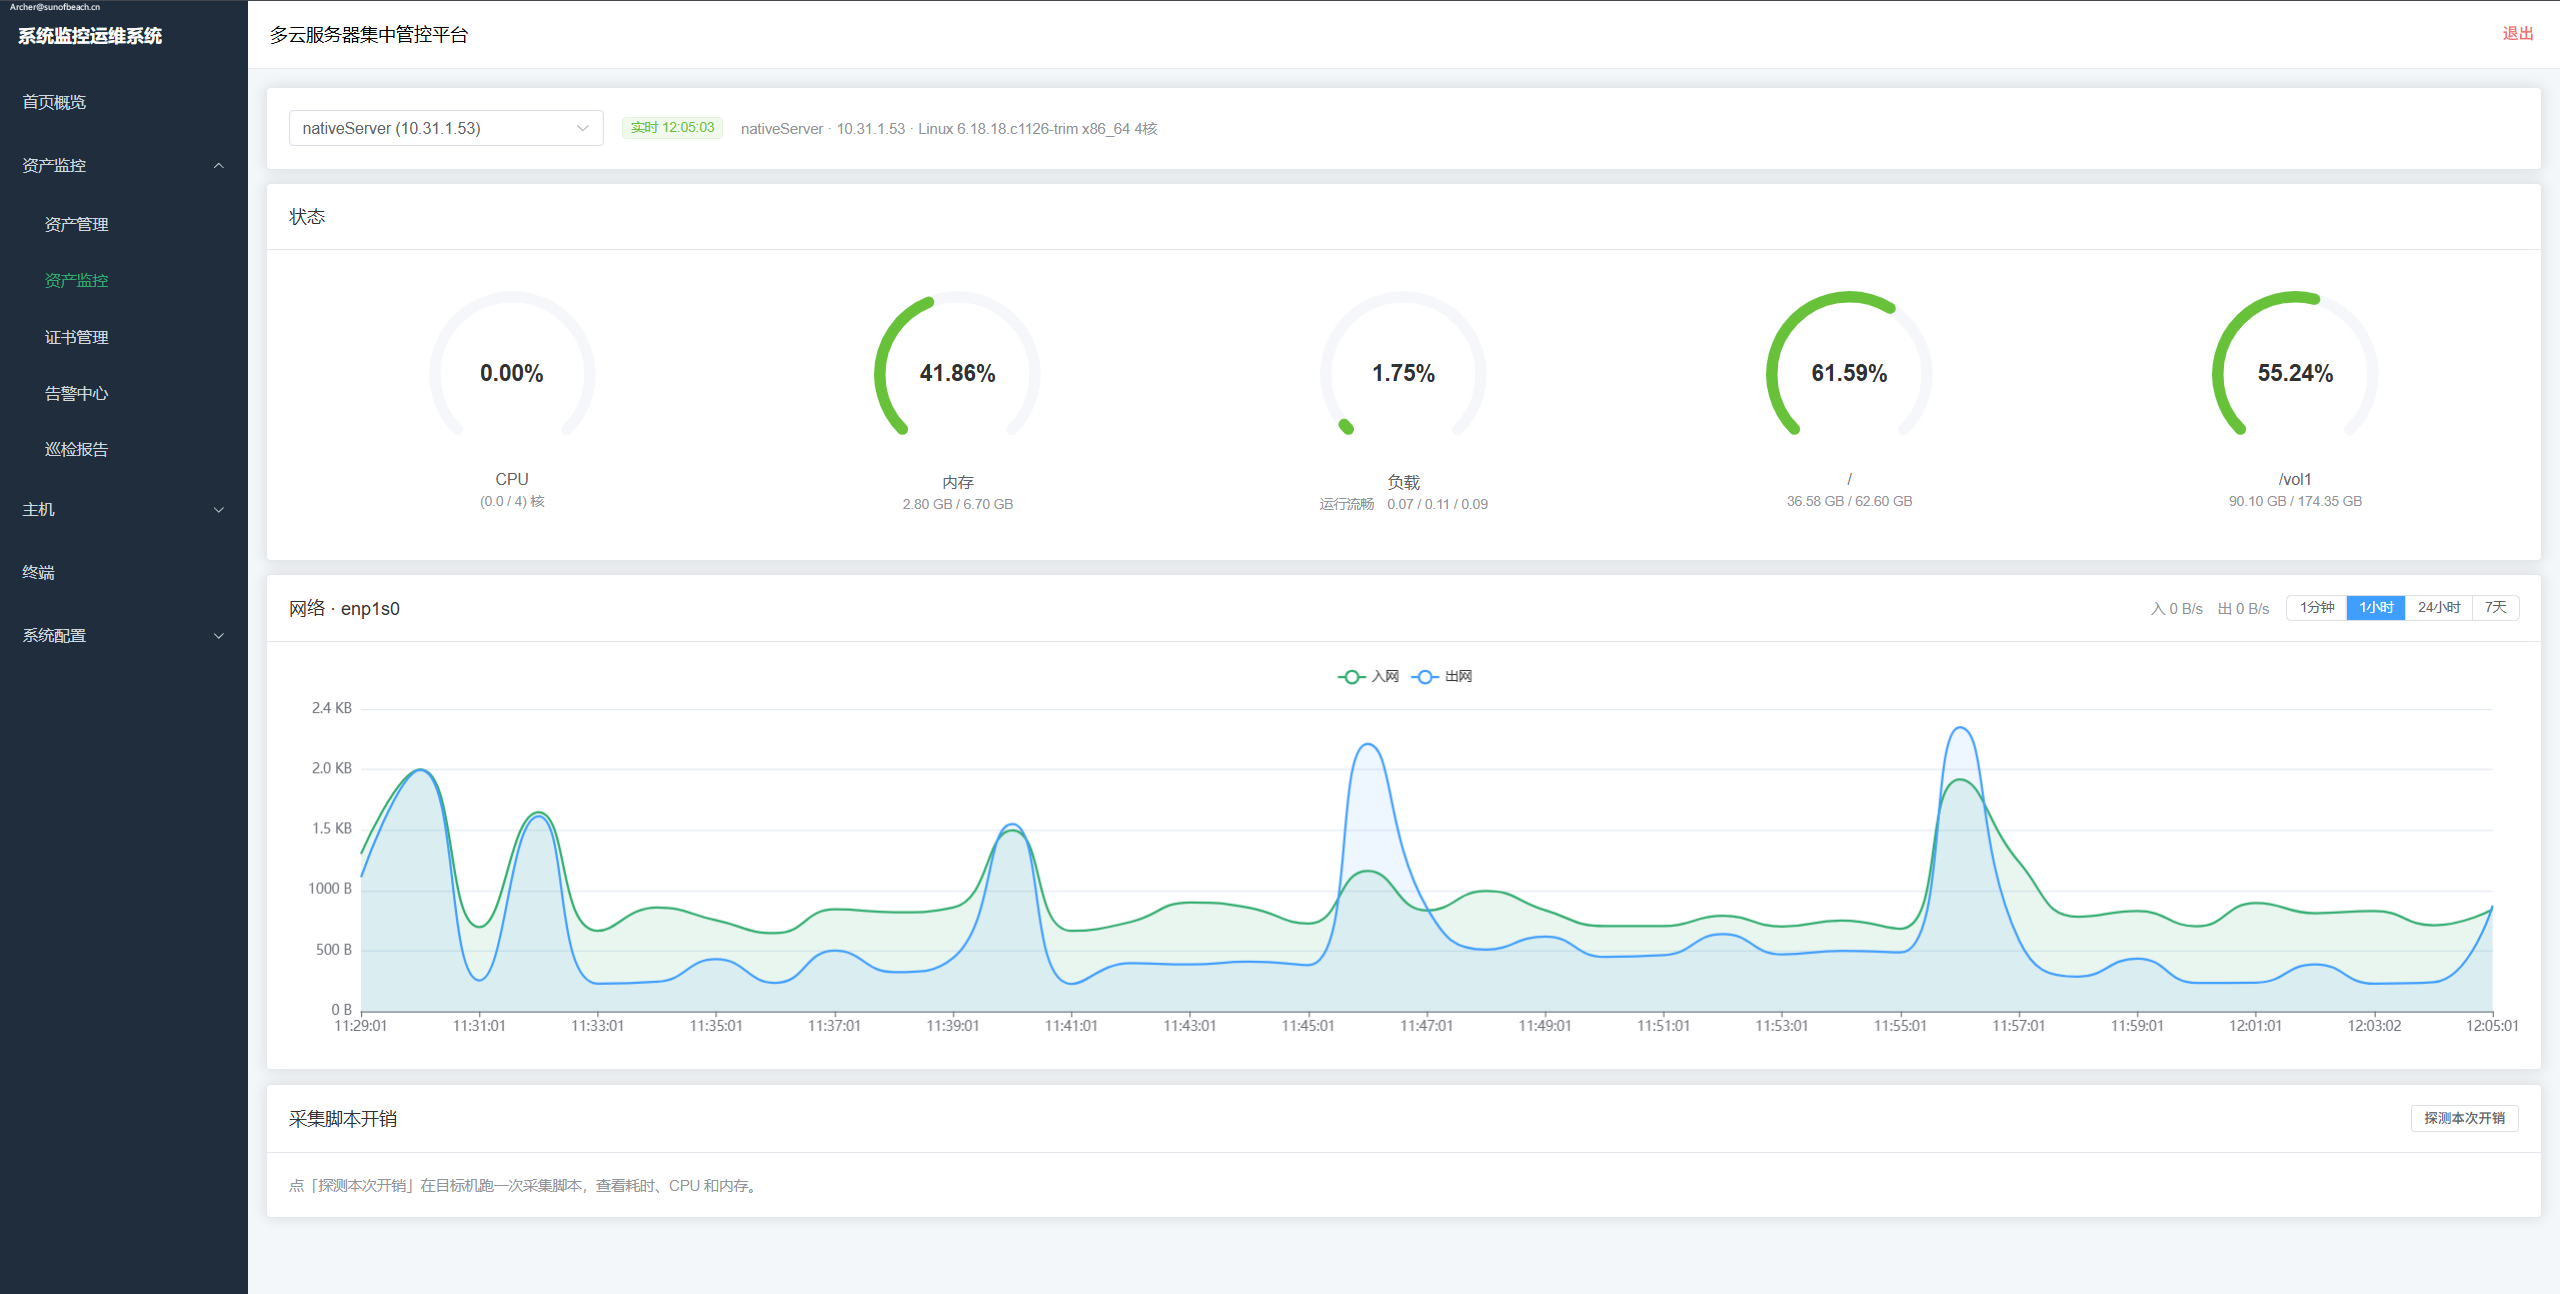
除了磁盘,还有内存,CPU,网络等等。但是目前网络还没设置预警。
内存满载
有些云服务中安装了k8s+kubesphere,添加容器时显示内存不够,有些配置刚好,当用户访问的时候却是满载红温了。
所以当达到配置的阈值时,可以去调节每个节点中内存的分配问题。
满负载
之前遇到一个满负载的问题,导致服务器进不去。通过通过AI分析,发现一个木马在服务器中进行挖矿。
功能不集中
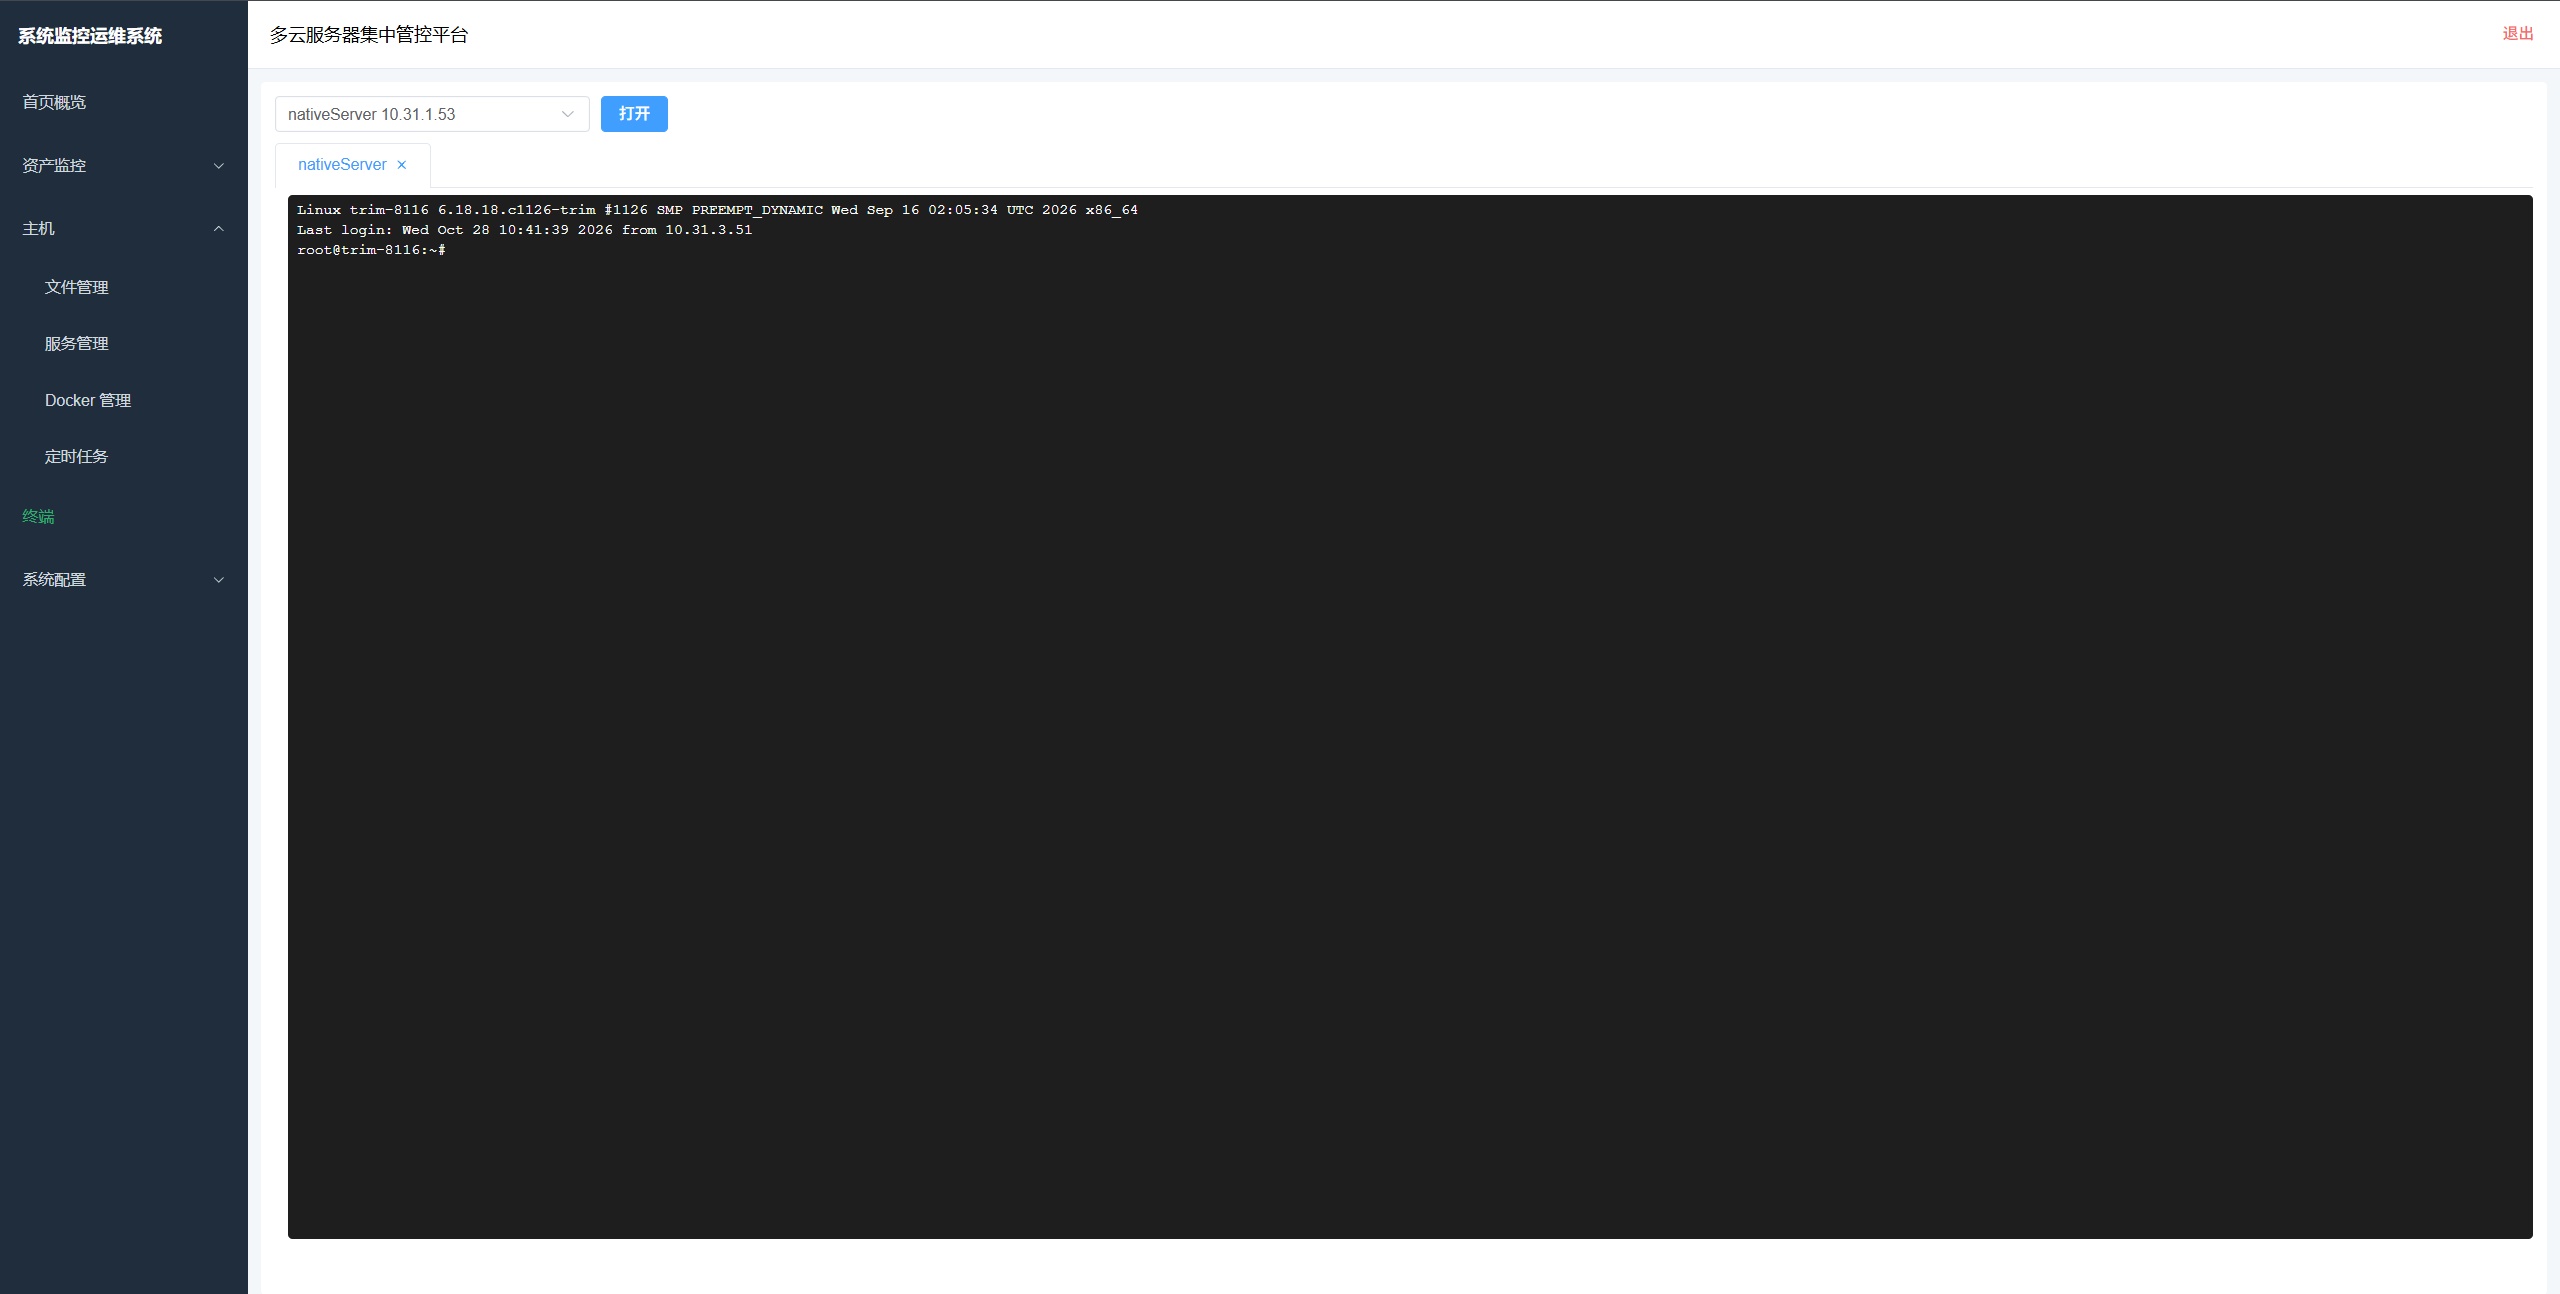
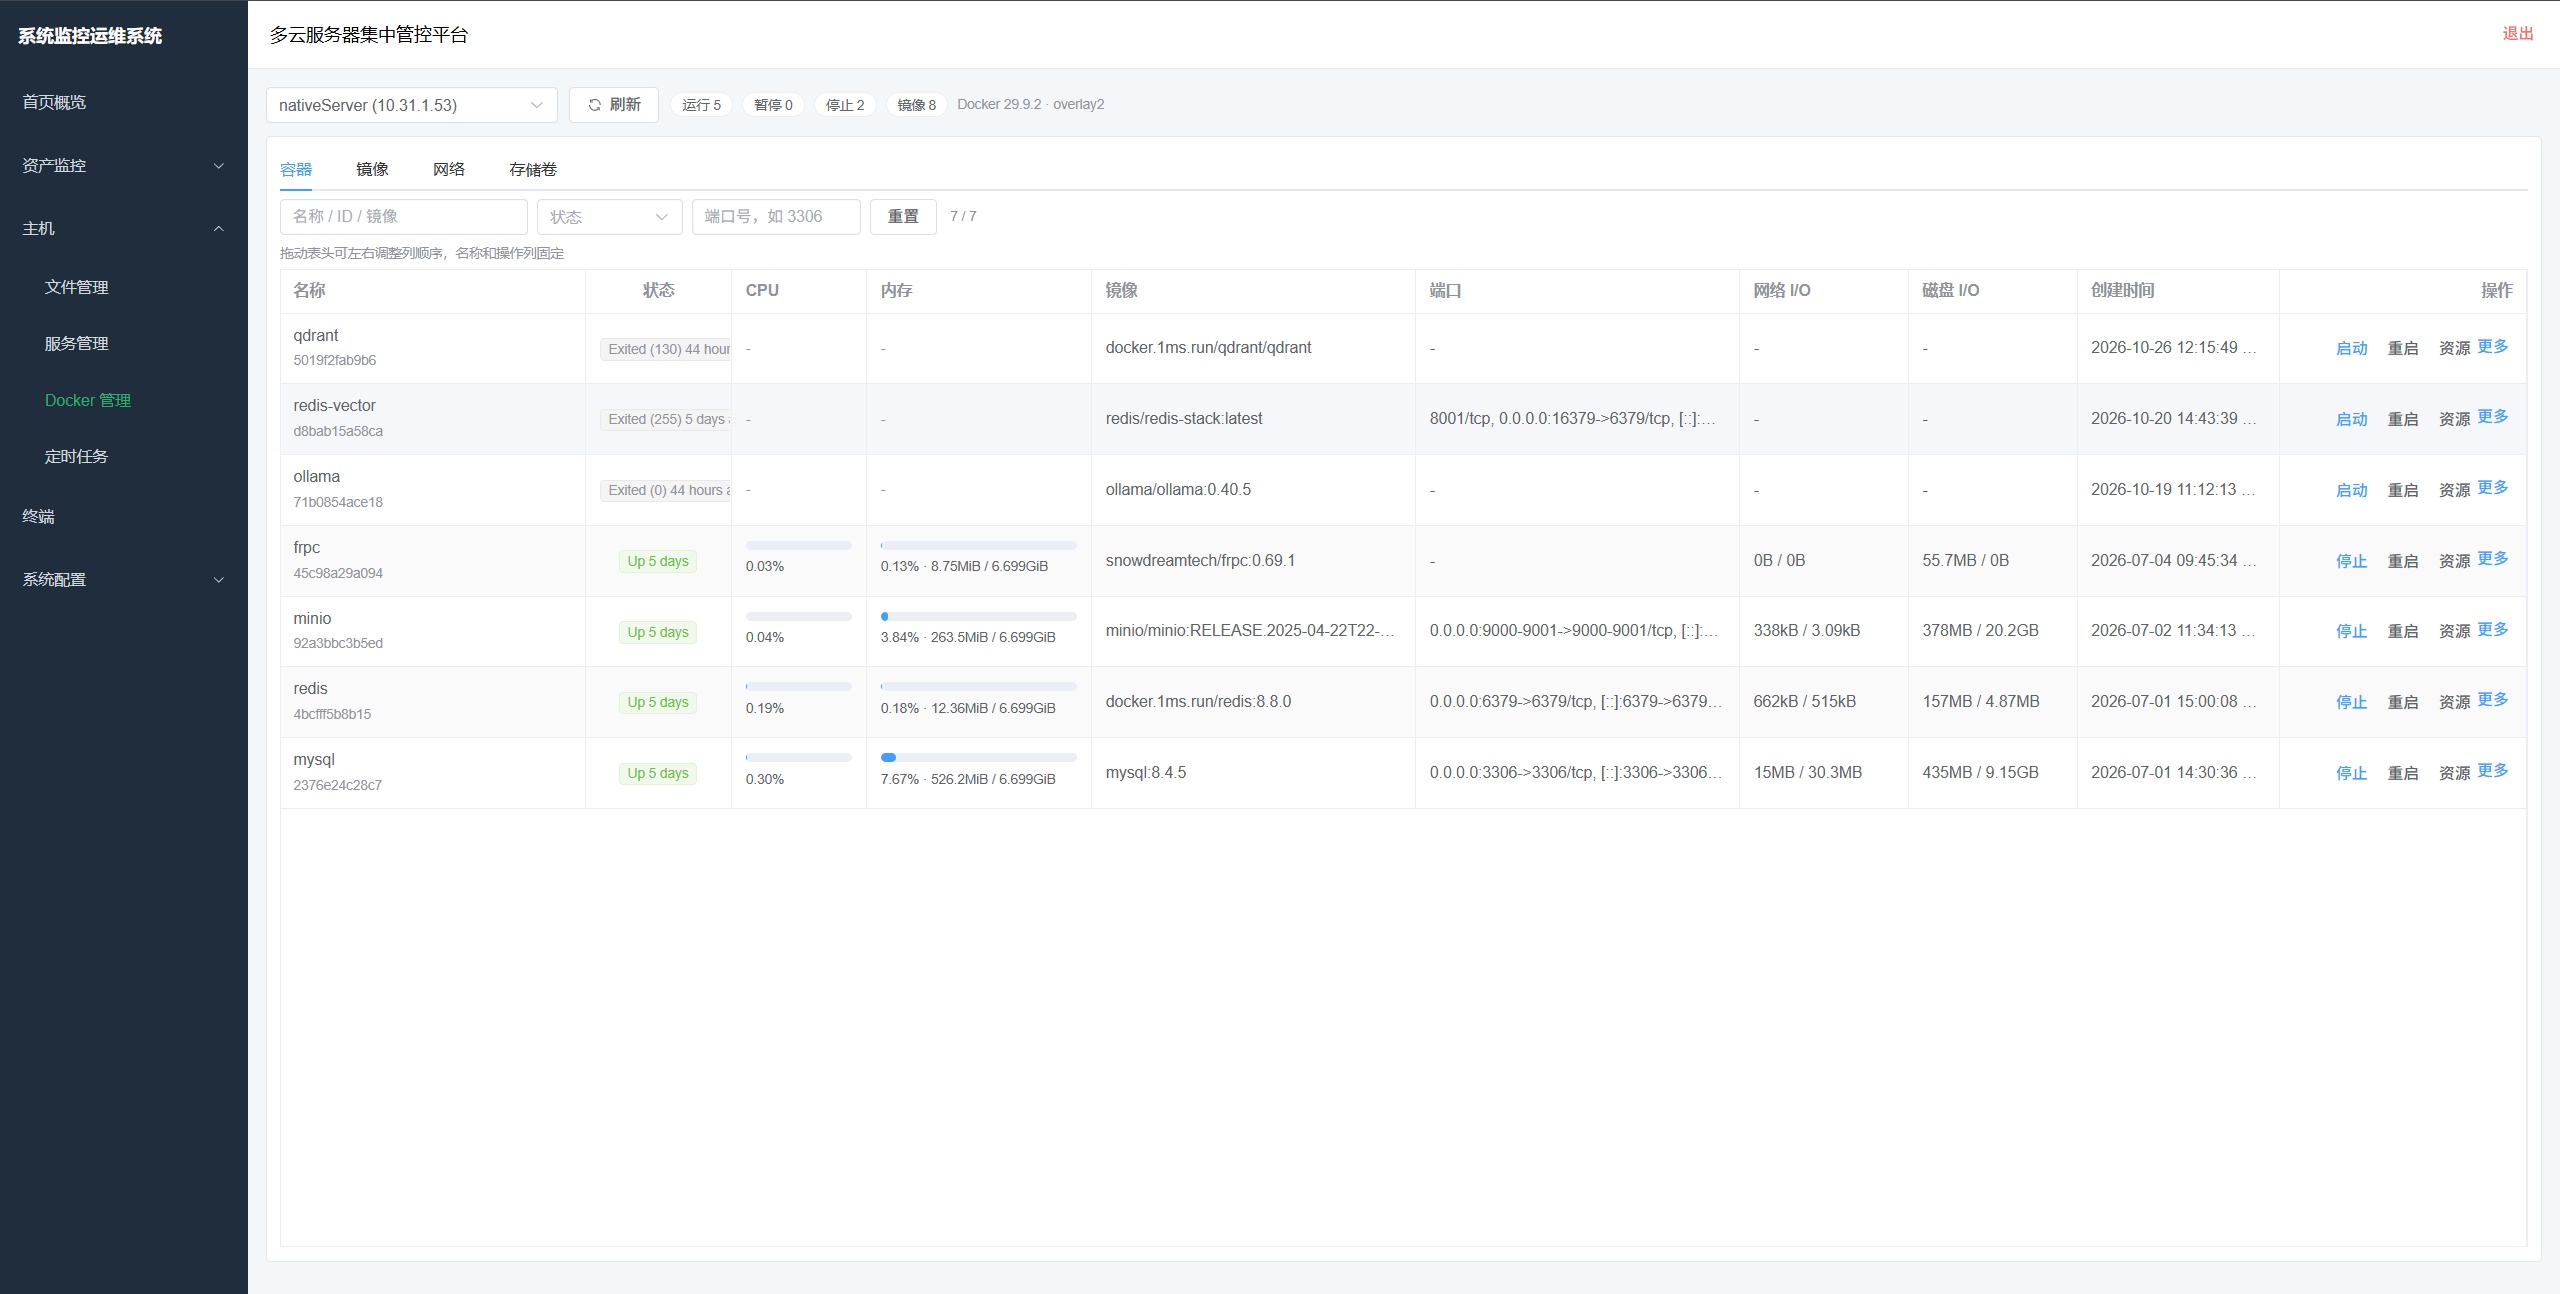
原本平台仅包含预警采集功能,如果通过ssh进入到服务器访问,又得打开一个ssh工具,十分的不爽。后面就把webssh、docker等集成到了平台中。
代码共享
目前代码中还有些功能还未经过认证,如果有需要的,可以结合自己的实际需求进行二次修改。