title: 索引
created: 2022-12-27T11:18:43Z
updated: 2022-12-28T16:24:38Z
索引
1. 索引的介绍
索引是通过某种算法,构建出一个数据模型,用于快速找出某个列中有一特定值的行。
如果没有索引,MySQL必须使用全表扫描方式,从第一条记录开始读完整个表直到找到对应结果,表越大,查询所花的时间越多,效率特别特别低。
如果有索引,MySQL能够快速到达一个大概的位置,再从一这个位置继续检索,而不必查看所有数据。
索引是加在字段上的,对于一个student表 执行如下SQL语句 :
select id, name from student where id = 10;如果没有索引,需要遍历全部学生直到找到学号为10的,遍历次数为8.
如果给id字段加了索引,假如加的是二叉搜索树,那么这句SQL只需要遍历8、10,遍历次数为2。
只有10条记录就能优化这么明显,100条呢?10000条呢?10000000条呢?

当然,索引并不是二叉搜索树这么简单,常见的索引结构如哈希、B+树,这些结构都很复杂。
2. 索引的本质
**索引是数据的一种,**MySQL数据库的数据是存储在磁盘中的,所以索引也是以文件的形式存储在磁盘中的。
不过索引文件在磁盘中究竟以何种方式存储,这是由索引的数据结构来决定的。同时,由于索引机制最终是由存储引擎实现,因此不同存储引擎下的索引文件,其保存在本地的格式也并不相同。
因为索引是以文件形式保存在磁盘的,对于一张很大的表创建索引时,并不会像约束一样直接在原表操作,而是重新在磁盘中创建新的文件来存储。假设表中有1000W条数据,那创建索引时,就需要将索引字段上的1000W个值全部拷贝到本地索引文件中,同时做好排序并与表数据产生映射关系。
3. 索引的结构
索引建立后也会在磁盘生成索引文件,那每个具体的索引节点该如何在本地文件中存放呢?这点是由索引的数据结构来决定的。比如索引的底层结构是数组,那所有的索引节点都会以Node1→Node2→Node3→Node4....这样的形式,存储在磁盘同一块物理空间中,不过MySQL的索引不支持数组结构,或者说数组结构不适合作为索引结构,MySQL索引支持的数据结构如下:
Hash类型:大部分存储引擎都支持,字段值不重复的情况下查询最快,无序。B+Tree类型:MySQL中最常用的索引结构,大部分引擎支持,有序。R-Tree类型:MyISAM引擎支持,也就是空间索引的默认结构类型。T-Tree类型:NDB-Cluster引擎支持,主要用于MySQL-Cluster服务中。
在上述的几种索引结构中,B+树和哈希索引是最常见的索引结构,几乎大部分存储引擎都实现了,对于后续两种索引结构在某些情况下也较为常见,但除开列出的几种索引结构外,MySQL索引支持的数据结构还有R+、R*、QR、SS、X树等结构。
3.1 Hash
Hash是一种算法,也叫散列算法,如何使用Hash来实现索引呢 ?
- 使用 算法 给加了索引的字段生成一个hashcode,这个hashcode映射到具体数据的地址
假如有如下指令要执行 :
insert into student(id, name, age) value (1, '小王', 18);
insert into student(id, name, age) value (2, '小刚', 17);
insert into student(id, name, age) value (3, '小蓝', 21);
给字段id添加索引,假如构建索引时hash使用的算法为哈希函数f(),它返回下面的值:
f('1') = 2414
f('2') = 4634
f('3') = 8381
则哈希索引的结构如下 :
| 键值 | 槽(hashcode) | 值 |
|---|---|---|
| 1 | 2414 | 指向第一行的指针 |
| 2 | 4634 | 指向第二行的指针 |
| 3 | 8381 | 指向第三行的指针 |
当查询时
select * from student where id = 2依旧会根据2计算出hashcode,得到指向第二行的指针,直接得到数据。而不是傻傻的遍历。
Hash的优点:
哈希算法时间复杂度为O(1),它是最快的,磁盘IO花费少
Hash的缺点:
Hash只能用到等值查询,不能范围和模糊查询。
hash索引不能用于外排序,hash索引存储的是hash码而不是键值,所以无法用于外排序。
hash索引中的hash码的计算可能存在hash冲突
3.2 B+树
B+树是使用最多的索引,在MySQL中创建索引时,其默认的数据结构就为B+Tree。
谈到B+树,必须要先说一下B树(多路平衡查找树)。
将999-1020插入到B树中如下 :

B树与二叉树的差别:
| 结构 | 节点key数量 | 孩子数量 |
|---|---|---|
| 二叉树 | 每一个节点可以有多个key | 每个节点可以有多个孩子 |
| B树 | 每一个节点最多有一个key | 每个节点最多有两个孩子 |
正是由于这些区别,在二叉树中插入100个数据可能有10层,在B树中插入可能只有3层。
接下来看看插入 999 - 1020到B+树会发生什么 :

会发现B+树中所有的数据都在叶子节点中出现,并且所有叶子节点构成一个链表。
B树与B+树的区别 :
- B+树所有的数据都在叶子节点中出现。
- B+树的非叶子节点只有key,叶子节点有key也有value
- B+树所有叶子节点构成一个链表。
在进行如下SQL时 :
select * from student where id between 1006 and 1011;使用B+树可以直接查找到1006和1011,1006和1011之间是链表结构,直接返回。
MySQL又对B+树进行了优化,在原有B+树的基础上,增加了一个指向相邻叶子节点的链表指针,形成了双向循环链表,提高区间访问的性能。
3.3 常见面试题之为什么用B+树
Q :为什么用B+树而不用二叉树?
- 极端情况下二叉树可能形成链表,再查询还是要遍历。
- 相同数据量下,二叉树的层级太高,读取磁盘的次数太多,浪费磁盘IO。
Q :为什么用B+树而不用Hash?
- Hash只支持等值查询,不能范围和模糊查询。而B+树支持。
- Hash可能出现Hash冲突,极端情况下还是个链表。
Q :为什么用B+树而不用B树?
- B+树是B树的变种,B树可以实现的B+树都可以实现。
- B+树扫库、扫表能力更强,因为B+树所有节点都形成了叶子节点,并且所有叶子节点组成了双向链表。
- B+树非叶子节点不存储数据,每一页中存储的键值更多,树的层级更少,IO次数变少。
- B+树永远是在叶子节点拿到数据,更加稳定。
4. 索引的分类
Q :请回答一下你知道的
MySQL索引类型。A :聚簇索引、非聚簇索引、唯一索引、主键索引、联合索引、全文索引、单列索引、多列索引、复合索引、普通索引、二级索引、辅助索引、次级索引、有序索引、
B+Tree索引、R-Tree索引、T-Tree索引、Hash索引、空间索引、前缀索引......
如果你这样回答,面试官可能笑笑不说话....

实际上MySQL中真的有这么多索引类型吗?其实并没有,MySQL索引主要按照数据结构、字段数量、功能逻辑来分类。

当被问到 :请回答一下你知道的MySQL索引类型。
按照功能逻辑分类下的索引叙述即可 。
按照数据结构分类已经说过,下面说一下按照功能与存储形式分类。
为什么不说按照字段数量的分类呢?在一个字段上加索引称为单列索引,在多个字段上加同一个索引叫做多列索引。功能逻辑分类中的唯一索引、主键索引...都是单列索引。
4.1 功能逻辑层次
可分为这几种 :
| 分类 | 含义 | 特点 | 关键字 |
|---|---|---|---|
| 普通索引 | 快速定位数据 | 可以有多个 | |
| 主键索引 | 针对主键创建的索引 | 唯一,主键默认加主键索引 | PRIMARY |
| 唯一索引 | 避免同一个表中的某一列出现重复值 | 可以有多个 | UNIQUE |
| 全文索引 | 全文索引查找的是文本中的关键词 类似ES的分词器 |
可以有多个 | |
| 空间索引 | 快速检索空间数据类型 | 可以有多个 |
- 普通索引 :给指定字段加索引,单纯的提高这个字段的查询效率。
- 主键索引 :一个表的主键默认加主键索引。
- 唯一索引 :加了非空约束的字段默认加唯一索引。
- 全文索引 :只能创建在
CHAR、VARCHAR、TEXT等这些文本类型字段上,而且使用全文索引查询时,条件字符数量必须大于3才生效,功能上类似ES的分词器。 - 空间索引 :MySQL提供了几种空间类型
GEOMETRY、POINT、LINESTRING、POLYGON,空间索引则是基于这些类型的字段建立的,也就是可以帮助我们快捷检索空间数据。
4.2 存储形式层次
| 分类 | 含义 | 特点 |
|---|---|---|
| 聚集索引 | 将数据存储与索引放到了一块,索引结构的==叶子节点保存了行数据== | 必须有,只能由一个 |
| 二级索引 | 将数据与索引分开存储,索引结构的==叶子节点关联的是对应的主键== | 可以有多个 |
在刚才我们说过,索引的本质是数据。如果构建索引,要给索引创建单独的文件存储。
聚集索引就是将数据与索引放到一起存储。
二级索引就是将数据与索引单独存储,那么如何通过索引找到数据呢?这就要说到回表查询。
使用上面的student表,给id构建聚集索引,name构建二级索引。
若执行如下SQL:
select * from student where id = 3;由于是聚集索引,只要根据索引查找到数据,就可以直接返回该数据。

若执行如下SQL:
select * from student where name = '何';由于是二级索引,会触发回表查询

简单描述就是 :
二级索引的叶子节点关联主键,需要先查出主键再拿着主键去聚集索引查行数据。
由于回表查询的存在,根据主键查询数据比根据其他字段查询数据快。
5. 索引的失效
在了解索引失效前,先来看看一个原理 :最左前缀原则。
5.1 最左前缀原则
对于多列索引 :
- 查询从索引的最左列开始,并且不跳过索引中的列。如果跳过某一列,索引将**
部分失效。** - 若查询语句中出现范围查询,范围查询后的所有字段都不走索引。
存在一个表 :student,对于 id、age、name 加多列索引 :idx_id_age_name,可知顺序是id -> age -> name
以下SQL语句的索引使用情况如下 :
-- 全部索引都将生效
-- 可见: 最左前缀原则的失效情况是未出现,对于顺序无要求.
select * from student where id = 1 and age = 14 and name = '小李';
select * from student where age = 14 and id = 1 and name = '小李';
select * from student where age = 14 and name = '小李' and id = 1;-- id是第一个,未出现,则idx_id_age_name索引全部失效
select * from student where age = 14 and name = '小李';-- age 未出现,从age开始失效。只用到了id的索引
select * from student where id = 1 and name = '小李';-- name未出现,从name开始失效。只用到了id和age的索引
select * from student where id = 1 and age = 14;对于范围查询导致索引失效的场景 :
-- id出现范围查询,id后的所有字段索引失效。
select * from student where id > 10 and age = 10 and name = '小李';
select * from student where age = 10 and id > 10 and name = '小李';
select * from student where age = 10 and name = '小李' and id > 10;
注意 :这两种索引失效称为最左前缀原则,只有多列索引会这样。
5.2 索引失效的场景
前两种多列索引失效的场景已经谈及,接下来列举一下其他的索引失效场景 :
(假设举例中的所有字段都加了索引)
最左前缀原则导致索引失效。
字符串类型使用时不加引号,索引失效。
sql复制代码-- 索引不失效: select * from user where phone = '0111'; -- 索引失效: select * from user where phone = 0111;模糊查询时
%在最前面,索引失效。sql复制代码-- 索引不失效: select * from user where phone like '187%'; select * from user where phone like '187%2321'; -- 索引失效: select * from user where phone like '%2321';加索引的字段不能计算。
sql复制代码-- 索引不失效: select * from user where salary > 10000; -- 索引失效: select * from user where salary * 1.2 > 10000;使用or连接条件时,只有两侧条件都加了索引才都生效,有一方没加都会全部失效。
6. 索引常见面试题
本标题的内容引自 :https://juejin.cn/post/7003527396427038733
面试官:我看你简历上写了MySQL,对MySQL InnoDB引擎的索引了解吗?
嗯嗯,使用索引可以加快查询速度,其实上就是将无序的数据变成有序(有序就能加快检索速度)
在InnoDB引擎中,索引的底层数据结构是B+树
面试官:那为什么不使用红黑树或者B树呢?
MySQL的数据是存储在硬盘的,在查询时一般是不能「一次性」把全部数据加载到内存中
红黑树是「二叉查找树」的变种,一个Node节点只能存储一个Key和一个Value
B和B+树跟红黑树不一样,它们算是「多路搜索树」,相较于「二叉搜索树」而言,一个Node节点可以存储的信息会更多,「多路搜索树」的高度会比「二叉搜索树」更低。
了解了区别之后,其实就很容易发现,在数据不能一次加载至内存的场景下,数据需要被检索出来,选择B或B+树的理由就很充分了(一个Node节点存储信息更多(相较于二叉搜索树),树的高度更低,树的高度影响检索的速度)
B+树相对于B树而言,它又有两种特性。
一、B+树非叶子节点不存储数据,在相同的数据量下,B+树更加矮壮。(这个应该不用多解释了,数据都存储在叶子节点上,非叶子节点的存储能存储更多的索引,所以整棵树就更加矮壮)
二、B+树叶子节点之间组成一个链表,方便于遍历查询(遍历操作在MySQL中比较常见)
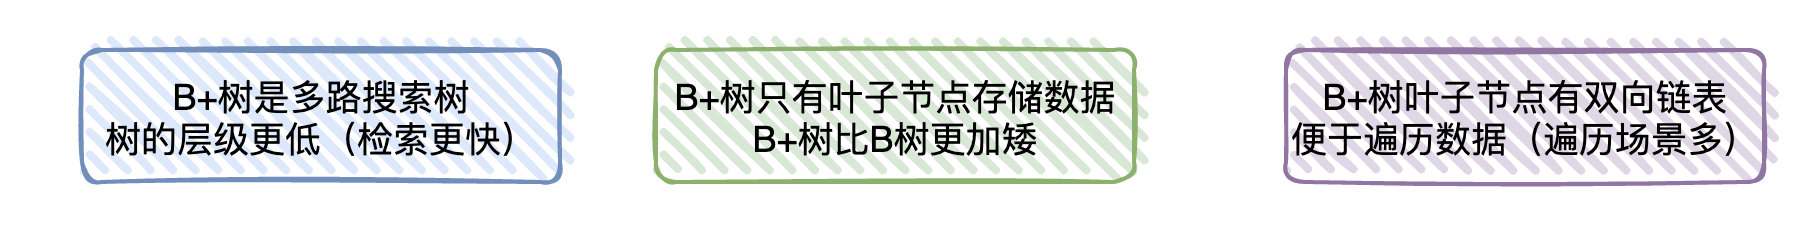
我稍微解释一下吧,你可以脑补下画面
我们在MySQL InnoDB引擎下,每创建一个索引,相当于生成了一颗B+树。
如果该索引是「聚集(聚簇)索引」,那当前B+树的叶子节点存储着「主键和当前行的数据」
如果该索引是「非聚簇索引」,那当前B+树的叶子节点存储着「主键和当前索引列值」
比如写了一句sql:select * from user where id >=10,那只要定位到id为10的记录,然后在叶子节点之间通过遍历链表(叶子节点组成的链表),即可找到往后的记录了。
由于B树是会在非叶子节点也存储数据,要遍历的时候可能就得跨层检索,相对麻烦些。
基于树的层级以及业务使用场景的特性,所以MySQL选择了B+树作为索引的底层数据结构。
对于哈希结构,其实InnoDB引擎是「自适应」哈希索引的(hash索引的创建由InnoDB存储引擎引擎自动优化创建,我们是干预不了)
面试官:嗯...那我了解了,顺便想问下,你知道什么叫做回表吗?
所谓的回表其实就是,当我们使用索引查询数据时,检索出来的数据可能包含其他列,但走的索引树叶子节点只能查到当前列值以及主键ID,所以需要根据主键ID再去查一遍数据,得到SQL 所需的列
举个例子,我这边建了给订单号ID建了个索引,但我的SQL 是:select orderId,orderName from orderdetail where orderId = 123
SQL都订单ID索引,但在订单ID的索引树的叶子节点只有orderId和Id,而我们还想检索出orderName,所以MySQL 会拿到ID再去查出orderName给我们返回,这种操作就叫回表
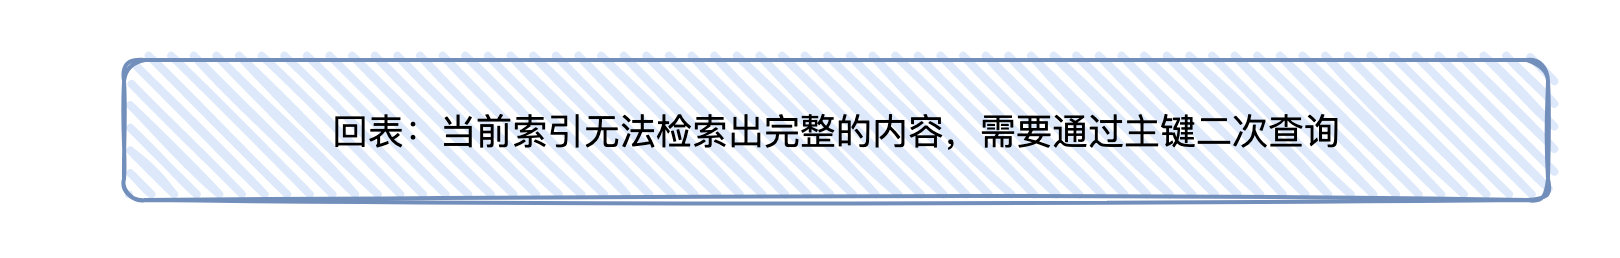
想要避免回表,也可以使用覆盖索引(能使用就使用,因为避免了回表操作)。
所谓的覆盖索引,实际上就是你想要查出的列刚好在叶子节点上都存在,比如我建了orderId和orderName联合索引,刚好我需要查询也是orderId和orderName,这些数据都存在索引树的叶子节点上,就不需要回表操作了。
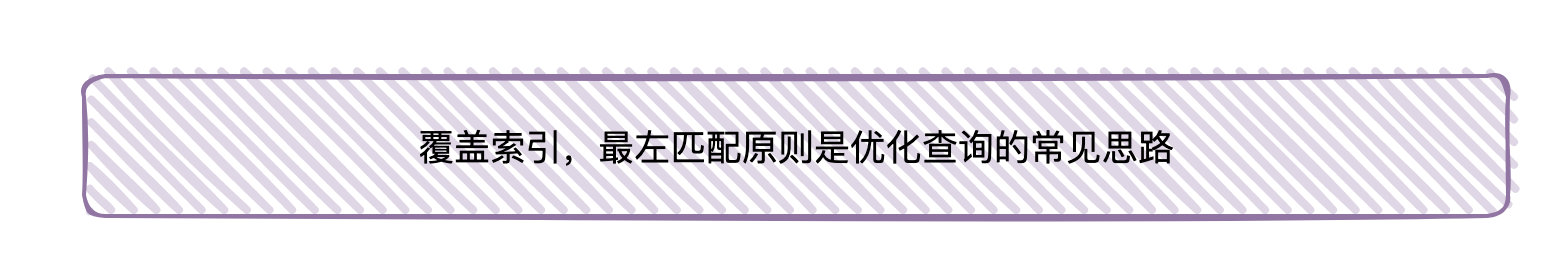
面试官:既然你也提到了联合索引,我想问下你了解最左匹配原则吗?
嗯,说明这个概念,还是举例子比较容易说明
如有索引 (a,b,c,d),查询条件 a=1 and b=2 and c>3 and d=4,则会在每个节点依次命中a、b、c,无法命中d
先匹配最左边的,索引只能用于查找key是否存在(相等),遇到范围查询 (>、<、between、like左匹配)等就不能进一步匹配了,后续退化为线性查找
这就是最左匹配原则
面试官:嗯嗯,我还想问下你们主键是怎么生成的?
主键就自增的
面试官:那假设我不用MySQL自增的主键,你觉得会有什么问题呢?
首先主键得保证它的唯一性和空间尽可能短吧,这两块是需要考虑的。
另外,由于索引的特性(有序),如果生成像uuid类似的主键,那插入的的性能是比自增的要差的
因为生成的uuid,在插入时有可能需要移动磁盘块(比如,块内的空间在当前时刻已经存储满了,但新生成的uuid需要插入已满的块内,就需要移动块的数据)
不使用主键自增,因为索引用的是B+树,插入数据时可能会移动数据。使用主键自增,插入数据时按照顺序往右边插入,不会移动数据
面试官:OK...
7. 总结及参考文献
OK~,本篇文章从索引的介绍、索引本质、索引结构、索引分类、索引失效、索引面试题等内容进行了全面概述,相信本章看下来,足够让你对MySQL索引机制有一个系统化的体系,那么我们下篇再见。
https://juejin.cn/post/7147609139974242317
https://juejin.cn/post/7003527396427038733